1
Format
Notre agent IA clarifie avec vous : qualitatif ou quantitatif.
Études primaires ad hoc pour instituts et équipes insights
Ils ne sont dans aucun panel et ne répondent pas pour des points. Nous les interrogeons là où ils sont déjà : sur les réseaux sociaux. Enquêtes ponctuelles, trackers, vos questionnaires sur le terrain. Et des simulations pour des pré-études indicatives.
 utilise Boomerang comme partie de l'échantillon des sondages de tendance SRF


Pourquoi est-ce important ?
Pas un argument contre les panels — un argument pour combler le vide qu'ils laissent.
36 % → 6 %
Taux de réponse des enquêtes téléphoniques, 1997 contre 2018.
Pew Research Center (US)
<1 % → 34 %
<1 % des membres de panels ont rempli 34 % de tous les questionnaires (dix plus grands panels US).
comScore, 2006
39 vs 0.2
Enquêtes par mois chez les panélistes aguerris. Les personnes tirées au hasard en font 0.2 en six mois.
Liljeberg/Krambeer, planung & analyse 1/2012 (DE)
1.5 %→3.1 %→3.9 %
Erreur absolue moyenne des prévisions électorales : 1970–1990, US 2016, US 2020.
FiveThirtyEight & AAPOR
Quel est le produit ?
1
Notre agent IA clarifie avec vous : qualitatif ou quantitatif.
2
Proposition de l'agent à partir de la stratégie et du sujet, un modèle, une page blanche ou le lien vers le vôtre, par exemple dans Qualtrics.
3
Des réponses simulées pour un résultat indicatif, issues de près de quatre ans de recherche sur les opinions synthétiques.
4
Rien à faire de votre côté. Recrutement ad hoc sur tous les réseaux sociaux, faisabilité vérifiée en amont, chaque quota assuré.
5
Pondérés dans le tableau de bord, en direct dès le terrain, avec analyses détaillées et rapport PDF.
Enquête ad hoc représentative, recrutement frais, quotas par âge, sexe et région. Taille d'échantillon au choix.
Votre questionnaire dans Qualtrics, SurveyMonkey, Nebu, etc. Nous fournissons le terrain, y compris pour les longs questionnaires.
Participants aux entretiens : sélectionnés, indemnisés, planifiés.
Le même questionnaire, rempli en quelques minutes. Pensé pour les pré-études et les petits budgets. Confidence Guard™ indique la plausibilité ; si elle ne suffit pas, un clic vers de vraies personnes.
Déclarée comme simulation, présentée séparément, jamais intégrée à un échantillon humain.
Le même instrument chaque trimestre, pour comparer l'évolution d'une vague à l'autre.
Douze indicateurs de marque, dont notoriété, image, recommandation (NPS), fidélité et préférence, plus le Brand Equity Score.
« Nous utilisons Boomerang Ideas pour obtenir rapidement des insights marché et consommateurs, pour nos clients et pour nous-mêmes. Cela nous aide à prendre des décisions éclairées et à proposer des concepts et des idées de campagne. »
 Patrick Glauser · associé gérant, TMI AG
« Les enseignements du Boomerang Brand Tracker ont été d'une valeur inestimable pour affiner et faire évoluer notre stratégie marketing. »
 Carsten Richter · Digital Manager, Lindt & Sprüngli
« Six enquêtes Boomerang ciblées sur plusieurs marchés – rapides, intuitives et menées avec plaisir. Les insights professionnels nous ont aidés à valider nos personas et à affiner notre ciblage en toute confiance. »
 Philipp Köstner · Lead Online Marketing, BERNINA International
Comment atteignons-nous les participants ?
Ici répondent des personnes que le terrain classique n'atteint plus. Des études primaires, pas des données aspirées du web.
L'algorithme fausse-t-il l'échantillon ?
Recruter par la publicité, c'est obtenir ceux qui cliquent sur des publicités — l'objection est fondée. Quatre mesures pour y répondre :
Chaque sous-groupe est ciblé séparément. L'algorithme ne peut donc pas se rabattre sur les utilisateurs les plus faciles à atteindre.
Pour CH, DE et AT : âge, sexe et région quotés simultanément, afin que le groupe le moins cher ne remplisse pas le quota du plus cher. Quotas classiques dans les autres marchés.
Pondéré selon les données de l'office statistique national, pas selon la structure d'un panel.
À plusieurs niveaux, notamment questions de contrôle d'attention, détection des répondants trop rapides et des doublons, reCAPTCHA et contrôle d'IP.
Pourquoi faire confiance à notre méthode ?
Deux études sur l'échantillonnage humain avec l'Université de Zurich : pré-étude 2021, étude de validation 2023/24, face à un panel en ligne établi.
81 % vs 37 %
Contrôles d'attention réussis.
Étude UZH II (USA) : n = 1'000 Boomerang, n = 1'000 Qualtrics
42 % vs 20 %
Restent dans l'étude au lieu d'abandonner.
Étude UZH II (USA) : n = 1'000 Boomerang, n = 1'000 Qualtrics
2.91 vs 3.04
Confiance dans la science (1–4), plus faible — lue comme un moindre biais de désirabilité sociale.
Étude UZH II (USA) : n = 1'000 par groupe, p = .001
3.76 vs 3.96
Expérience des enquêtes, plus faible — lue comme des répondants moins rodés.
Étude UZH II (USA) : n = 1'000 par groupe, p < .001
2 sur 3
Sur deux votations sur trois, plus proche du résultat que les instituts établis.
Pré-étude UZH : 13 enquêtes avec n = 416 à 976, dont trois votations
0.25 vs 3.6
Écart en points, Nevada 2024. Analyse interne, cas isolé.
100 % échantillon humain, US 2024
1'000 en 6 jours
Durée de terrain de la pré-étude. L'institut a eu besoin de 10 jours pour le même échantillon.
Pré-étude UZH : n = 1'000
Ces chiffres concernent de vraies personnes, recrutées ad hoc sur TikTok, Snapchat, Facebook et d'autres. Les preuves pour la simulation figurent plus bas.
Que valent les pré-études synthétiques ?
Ce qui compte, c'est sur quoi repose la simulation et ce qui se passe quand elle ne suffit pas.
Entraînée sur des décennies de données d'enquête de gfs.bern en Suisse et sur des données d'autres partenaires de recherche internationaux — pas sur du texte web.
Mesurée sur cinq études que le modèle n'a jamais vues : 82.6 % de recouvrement*entre distributions de réponses simulées et réelles. Les modèles frontières sans cet entraînement restent sous 52 %.
Chaque simulation est notée par Confidence Guard™, un second modèle de contrôle indépendant : la plausibilité, de 0 à 10.
Plus elle est élevée, plus le résultat est solide.
La simulation tient. Travaillez avec le résultat.
Le classement est juste, le pourcentage exact pas encore. Avant la décision budgétaire, vérifiez avec Human Sampling (dans l'outil).
La simulation ne suffit pas — cette question doit être posée à de vraies personnes. Nous le disons à côté du résultat, pas en petits caractères.
Le recrutement nous appartient : nos propres canaux, pour chaque étude. 3 à 7 jours jusqu'au résultat.
Mesurer sa simulation à des données de panel, c'est hériter de leurs lacunes. Notre référence : des personnes fraîchement recrutées.
La seule plateforme qui exploite elle-même les deux moteurs et les compare en continu.
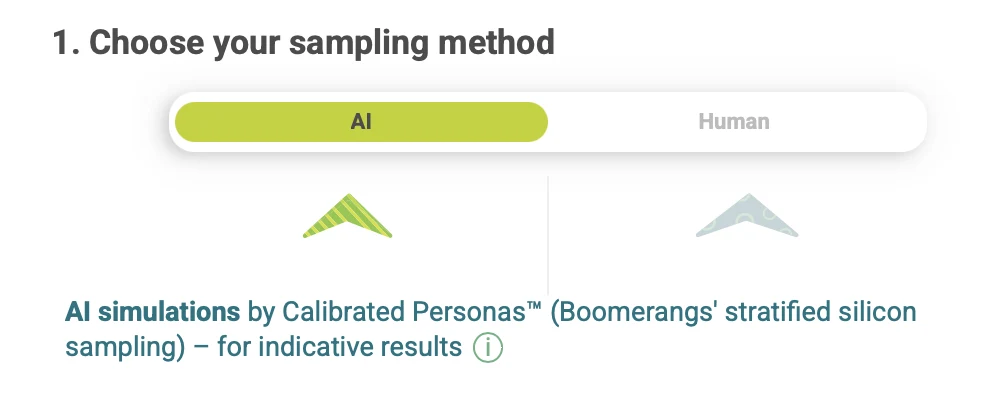
* Les 82.6 % proviennent d'études de validation suisses. La plausibilité mesure la cohérence et l'adéquation, jamais l'exactitude par rapport à un résultat connu.
Confidence Guard™ recommande, la décision reste humaine. Nous étudions l'étape automatique avec Bâle et Johns Hopkins — de la recherche, pas une fonctionnalité.
Soutenu à plusieurs reprises par Innosuisse depuis 2020. Le projet en cours, « Confidence-Driven Augmentation of Synthetic Survey Data », est mené avec l'Université de Bâle et la Johns Hopkins University.
Coûts et contact
Allemagne dès CHF 4 par réponse complète, Suisse et Autriche dès 5. Vous mandatez directement.
Le prix devient ferme avec le pré-test gratuit. Si nous ne trouvons pas votre cible, vous êtes remboursé.
CHF 10–15 par complété
CHF 3'000–4'500 pour n = 300 · hors TVA
Au-dessus du prix de base, car la question filtre restreint la cible.
Sans filtre, population suisse : CHF 5–10 par complété. CHF 1'500–3'000 pour n = 300.
dès EUR 4 par complété
dès EUR 1'200 pour n = 300 · hors TVA
Prix de base Allemagne, population générale.
Une question filtre restreint la cible et augmente le prix ; de combien dépend de son incidence. La fourchette figure dans l'offre.
dès USD 3 par complété
dès USD 900 pour n = 300 · hors TVA
Prix de base États-Unis, population générale.
Une question filtre restreint la cible et augmente le prix ; de combien dépend de son incidence. La fourchette figure dans l'offre.
uniquement les crédits utilisés
CHF 1'950 · 4'950 · 11'950
même prix, Pro inclus
1 crédit = CHF 1. L'offre fait foi.
Réponse sous 1 à 3 jours ouvrables avec faisabilité, fourchette de prix et proposition de pré-test.
24 pays : Afrique du Sud, Allemagne, Arabie saoudite, Argentine, Australie, Autriche, Brésil, Canada, Corée du Sud, Espagne, États-Unis, France, Inde, Italie, Kenya, Mexique, Nigeria, Pologne, Portugal, Royaume-Uni, Suède, Suisse, Tchéquie et Thaïlande. Pour la Suisse, l'Allemagne et l'Autriche, nous proposons aussi des quotas croisés sur demande, avec supplément.
DE dès CHF 4 par réponse complète, CH/AT dès 5. Population suisse générale typiquement 5–10.
Le terrain dure 3 à 7 jours selon l'échantillon et le questionnaire. Vous voyez les premières réponses en direct.
Aux pré-études : des résultats indicatifs en quelques minutes, évalués par Confidence Guard. Le passage à de vraies personnes se fait en un clic.
Entre autres : contrôles d'attention, détection des speeders et des doublons, reCAPTCHA, contrôle d'IP. Incitations équitables à la minute, après contrôle qualité.
Le rapport et les données brutes vous appartiennent. Nous collectons le minimum, anonymisons entièrement et respectons le RGPD et la nLPD.
⠿ verschieben
Als anonym